Hiển thị các bài đăng có nhãn thuật toán AI. Hiển thị tất cả bài đăng

Thuật toán A* tìm đường đi ngắn nhất trong đồ thị [ Cùng học AI ]

Thuật toán A* (A-star) là một thuật toán tìm đường sử dụng trong các lĩnh vực như trí tuệ nhân tạo, đồ họa máy tính, và robot học. Nó được sử dụng để tìm đường đi ngắn nhất từ điểm khởi đầu đến điểm đích trên một đồ thị. 

Thuật toán A* tìm đường đi ngắn nhất trong đồ thị [ Cùng học AI ]


Thuật toán A* kết hợp hai yếu tố chính:

1. Giá trị chi phí đi từ điểm khởi đầu đến điểm hiện tại (g(n)).

2. Ước lượng chi phí từ điểm hiện tại đến đích (h(n)), còn gọi là hàm heuristic.

Tổng chi phí của một nút n được tính bằng công thức: 

 f(n) = g(n) + h(n)

Trong đó:

-  g(n) là chi phí từ điểm khởi đầu đến nút n.

-  h(n) là chi phí ước lượng từ nút n đến đích (hàm heuristic).

Thuật toán A* hoạt động bằng cách khám phá các nút với giá trị f(n) nhỏ nhất trước, đảm bảo rằng nó tìm ra con đường ngắn nhất nếu hàm heuristic h(n) là admissible (không bao giờ đánh giá quá cao chi phí từ n đến đích).


* Có thể bản quan tâm: [MMO] Hướng Dẫn *Kiếm Tiền Tự Động* Với Các Ứng Dụng Treo Máy *CỰC KỲ ĐƠN GIẢN VÀ HIỆU QUẢ*


### Sơ đồ thuật toán A*

1. Khởi tạo:

   - Tạo danh sách mở (open list) và thêm nút bắt đầu vào danh sách này. Khởi tạo danh sách đóng (closed list) rỗng.

   - Đặt giá trị g(n) của nút bắt đầu là 0 và f(n) = g(n) + h(n).

2. Lặp lại các bước sau cho đến khi danh sách mở trống hoặc tìm thấy điểm đích:

   - Chọn nút có giá trị f(n) nhỏ nhất trong danh sách mở và gán nó là nút hiện tại.

   - Nếu nút hiện tại là đích, tái tạo đường đi từ điểm khởi đầu đến điểm đích và kết thúc.

   - Di chuyển nút hiện tại từ danh sách mở sang danh sách đóng.

   - Đối với mỗi hàng xóm của nút hiện tại:

     + Nếu hàng xóm nằm trong danh sách đóng, bỏ qua nó.

     + Nếu hàng xóm không nằm trong danh sách mở, thêm nó vào danh sách mở và tính các giá trị g(n), h(n), và f(n).

     + Nếu hàng xóm đã nằm trong danh sách mở, kiểm tra xem đường đi hiện tại đến hàng xóm có tốt hơn không. Nếu có, cập nhật giá trị g(n), h(n) và f(n) của hàng xóm và cập nhật nút cha.

3. Kết thúc:

   - Nếu danh sách mở trống và điểm đích không được tìm thấy, báo rằng không có đường đi.

### Mô tả step-by-step các bước

1. Initialization (Khởi tạo):

   - Đặt nút bắt đầu (start) vào danh sách mở (open list).

   - Thiết lập g_score của nút bắt đầu là 0.

   - Tính toán f_score của nút bắt đầu bằng cách cộng g_score và heuristic (h(n)).

2. Loop until the open list is empty or the destination is found (Lặp lại cho đến khi danh sách mở trống hoặc tìm thấy đích):

   - Step 1: Chọn nút có giá trị f(n) nhỏ nhất trong danh sách mở (gọi là nút hiện tại).

   - Step 2: Nếu nút hiện tại là điểm đích, tái tạo và trả về đường đi.

   - Step 3: Di chuyển nút hiện tại từ danh sách mở sang danh sách đóng.

   - Step 4: Đối với mỗi hàng xóm của nút hiện tại:

     + Step 4.1: Nếu hàng xóm nằm trong danh sách đóng, bỏ qua nó.

     + Step 4.2: Tính g_score tạm thời (tentative_g_score) cho hàng xóm.

     + Step 4.3: Nếu hàng xóm không nằm trong danh sách mở hoặc tentative_g_score nhỏ hơn g_score hiện tại của hàng xóm:

        Cập nhật nút cha của hàng xóm là nút hiện tại.

        Cập nhật g_score và f_score của hàng xóm.

        Nếu hàng xóm không nằm trong danh sách mở, thêm nó vào danh sách mở.

3. ermination (Kết thúc):

   - Nếu danh sách mở trống và điểm đích không được tìm thấy, báo rằng không có đường đi.


### Ví dụ cụ thể

Giả sử chúng ta có một đồ thị đơn giản:


- Bắt đầu tại A, cần tìm đường ngắn nhất đến F.

- Hàm heuristic sử dụng khoảng cách Manhattan.

**Step-by-step:**

1. Initialization:

   - Đặt A vào danh sách mở. g(A) = 0, h(A) = heuristic(A, F), f(A) = g(A) + h(A).

2. Loop:

   Iteration 1:

   - Chọn A (f(A) = 0 + h(A)).

   - Di chuyển A từ danh sách mở sang danh sách đóng.

   - Xem xét các hàng xóm của A: B, C.

     + Với B: tentative_g(B) = g(A) + 1 = 1. Đặt g(B) = 1, h(B), f(B) = g(B) + h(B).

     + Với C: tentative_g(C) = g(A) + 4 = 4. Đặt g(C) = 4, h(C), f(C) = g(C) + h(C).

   - Thêm B và C vào danh sách mở.

   Iteration 2:

   - Chọn B (vì f(B) nhỏ hơn f(C)).

   - Di chuyển B từ danh sách mở sang danh sách đóng.

   - Xem xét các hàng xóm của B: A, D, E.

     + Với D: tentative_g(D) = g(B) + 2 = 3. Đặt g(D) = 3, h(D), f(D) = g(D) + h(D).

     + Với E: tentative_g(E) = g(B) + 5 = 6. Đặt g(E) = 6, h(E), f(E) = g(E) + h(E).

   - Thêm D và E vào danh sách mở.

   Iteration 3:

   - Chọn D (f(D) nhỏ hơn f(C) và f(E)).

   - Di chuyển D từ danh sách mở sang danh sách đóng.

   - Xem xét các hàng xóm của D: B, E, F.

     + Với F: tentative_g(F) = g(D) + 1 = 4. Đặt g(F) = 4, h(F) = 0, f(F) = g(F) + h(F).

   - Thêm F vào danh sách mở.

   Iteration 4:

   - Chọn F (f(F) nhỏ nhất).

   - F là điểm đích, tái tạo và trả về đường đi: A -> B -> D -> F.

Vậy, đường đi ngắn nhất từ A đến F là A -> B -> D -> F.


Dưới đây là một ví dụ chương trình ứng dụng của thuật toán A* với Python:

'''python'''

import heapq

def heuristic(a, b):

    return abs(a[0] - b[0]) + abs(a[1] - b[1])

def a_star(graph, start, end):

    open_list = []

    heapq.heappush(open_list, (0, start))

    came_from = {}

    g_score = {node: float('inf') for node in graph}

    g_score[start] = 0

    f_score = {node: float('inf') for node in graph}

    f_score[start] = heuristic(start, end)


    while open_list:

        current = heapq.heappop(open_list)[1]


        if current == end:

            path = []

            while current in came_from:

                path.append(current)

                current = came_from[current]

            path.append(start)

            return path[::-1]

        for neighbor in graph[current]:

            tentative_g_score = g_score[current] + graph[current][neighbor]

            if tentative_g_score < g_score[neighbor]:

                came_from[neighbor] = current

                g_score[neighbor] = tentative_g_score

                f_score[neighbor] = g_score[neighbor] + heuristic(neighbor, end)

                heapq.heappush(open_list, (f_score[neighbor], neighbor))

    return None


# Ví dụ đồ thị (graph) với chi phí giữa các điểm

graph = {

    'A': {'B': 1, 'C': 4},

    'B': {'A': 1, 'D': 2, 'E': 5},

    'C': {'A': 4, 'F': 3},

    'D': {'B': 2, 'E': 1},

    'E': {'B': 5, 'D': 1, 'F': 1},

    'F': {'C': 3, 'E': 1}

}


start = 'A'

end = 'F'

path = a_star(graph, start, end)

print(f"Đường đi ngắn nhất từ {start} đến {end} là: {path}")

```


### Giải thích chương trình:

1. Heuristic function: Hàm heuristic được định nghĩa để tính khoảng cách Manhattan giữa hai điểm.

2. A* function: Hàm `a_star` thực hiện thuật toán A*.

   - open_list: Danh sách mở chứa các nút cần được khám phá. Các nút được sắp xếp theo giá trị `f(n)`.

   - came_from: Từ điển lưu trữ các nút và nút cha của chúng để tái tạo đường đi ngắn nhất.

   - g_score: Từ điển lưu trữ chi phí từ điểm khởi đầu đến mỗi nút.

   - f_score: Từ điển lưu trữ giá trị `f(n)` cho mỗi nút.

3. Main loop: Vòng lặp chính khám phá các nút với giá trị `f(n)` nhỏ nhất trước.

4. Reconstruction: Khi điểm đích được tìm thấy, hàm sẽ tái tạo lại đường đi ngắn nhất bằng cách đi ngược từ điểm đích đến điểm khởi đầu thông qua `came_from`.


Chương trình này sẽ in ra đường đi ngắn nhất từ điểm bắt đầu 'A' đến điểm kết thúc 'F'.

Giải thuật tiến hóa - thuật toán di truyền

Giải thuật tiến hóa - thuật toán di truyền

Giải thuật tiến hóa - thuật toán di truyền

Nội dung:
1. Giải thuật tiến hóa
2. Thuật toán di truyền
3. Các quá trình cơ bản trong thuật toán di truyền
4. Các tham số của thuật toán di truyền
5. Cài đặt giải thuật di truyền
--------------------------------

1. Giải thuật tiến hóa

Giải thuật tiến hóa (Evolutionary Computations - EC) bao gồm: thuật toán di truyền (Genetic Algorithm - GA), thuật toán tiến hóa vi phân (Differential Evolution- DE), qui hoạch tiến hóa (Evolutionary programming - EP) và chiến lược tiến hóa (Evolution Strategies - ES) dựa trên nền tảng tiến hóa tự nhiên đó cũng là các phương pháp tự nhiên nhằm giải quyết bài toán tối ưu và tìm kiếm. Mục tiêu cơ bản của EC là cơ cấu tính toán nhằm tạo ra sự tiến hóa của quần thể gồm nhiều cá thể với mục đích quần thể sau “tốt hơn” quần thể trước. Các toán tử sử dụng trong EC bao gồm: lai ghép (crossover), đột biến (mutation) và chọn lọc (selection). Các toán tử này kết hợp với nhau trong một mô hình tiến hóa và được điều khiển bởi một vài tham số như kích cỡ quần thể, xác suất lai ghép, xác suất đột biến... Hình thức sử dụng rộng rãi EC là thuật toán di truyền (GA).

2. Thuật toán di truyền

Giống như giải thuật tiến hóa nói chung, thuật toán di truyền (GA) hình thành dựa trên quan niệm cho rằng quá trình tiến hóa tự nhiên là quá trình hoàn hảo và hợp lý nhất và tự nó đã mang tính tối ưu. Đây là một tiên đề đúng, không thể chứng minh được nhưng phù hợp với thực tế khách quan. Tính tối ưu trong tự nhiên thể hiện ở chỗ thế hệ sau bao giờ cũng tốt hơn thế hệ trước nhờ hai quá trình cơ bản là sinh sản và chọn lọc tự nhiên. Những cá thể nào phát triển thích nghi với môi trường sẽ tồn tại và ngược lại, những cá thể nào không thích nghi với môi trường sẽ bị đào thải. Sự thay đổi của môi trường sẽ tác động đến quá trình tiến hóa và bản thân quá trình tiến hóa cũng có tác động và làm thay đổi môi trường. Cá thể mới sinh ra trong quá trình tiến hóa nhờ vào sự lai ghép ở thế hệ cha mẹ. Một cá thể mới có thể mang những đặc tính của cha mẹ ở thế hệ trước (di truyền) hoặc mang những đặc tính mới hoàn toàn (đột biến). Di truyền và đột biến là hai cơ chế quan trọng như nhau trong quá trình tiến hóa mặc dù xác suất để xảy ra hiện tượng đột biến nhỏ nhiều (hàng chục đến
hàng trăm lần tùy từng quá trình) so với hiện tượng di truyền. Mặc dù cơ chế là ngẫu nhiên nhưng thuật toán di truyền không phải là một thuật toán ngẫu nhiên. Thuật toán khai thác và tận dụng được một cách hiệu quả thông tin quá khứ để có được những kết quả mới đạt kết quả như mong muốn. Các cải tiến trong việc sử dụng thuật toán
di truyền đã làm tăng thêm hiệu quả của việc sử dụng thuật toán trong các bài toán phức tạp. Điều này thể hiện ở việc giảm thời gian tính toán ngày càng hiệu quả mà ta sẽ tìm hiểu cụ thể hơn ở dưới đây.

3. Các quá trình cơ bản trong thuật toán di truyền

a) Mã hóa dữ liệu: hay còn gọi là biểu diễn di truyền cho lời giải của bài toán: Đây là bước đầu tiên và rất quan trọng đối với việc tìm ra lời giải của bài toán. Mỗi lời giải của bài toán được biểu diễn dưới dạng một chuỗi ký tự hữu hạn hay còn được gọi là một nhiễm sắc thể. Các ký tự có thể là số nhị phân, số thập phân, … tùy vào từng bài toán cụ thể. Trong quá trình này, việc mã hóa cái gì, mã hóa như thế nào, trật tự các thành phần trong nhiễm sắc thể ra sao,… luôn là những thách thức cho những người giải bài toán.

b) Khởi tạo quần thể (xây dựng tập hợp nghiệm ban đầu): có thể ngẫu nhiên hoặc không ngẫu nhiên: Có nhiều cách để khởi tạo giá trị quần thể nghiệm ban đầu, tùy từng bài toán mà ta lựa chọn phương pháp phù hợp. Thông thường, hệ nghiệm ban đầu được chọn ngẫu nhiên trong không gian tìm kiếm. Tuy vậy, việc chọn này cũng cần phải xem xét về tương quan giữa độ thích nghi của các nhiễm sắc thể để tránh tình trạng nghiệm tìm ra là nghiệm tối ưu cục bộ hay còn gọi là cực trị địa phương. Còn vấn đề số lượng nghiệm của tập nghiệm hay qui mô của quần thể cũng cần được xem xét kỹ dựa vào độ phức tạp của bài toán, độ chính xác yêu cầu (cao hay thấp) và thời gian tính toán yêu cầu (nhanh hay chậm)

c) Xác định hàm thích nghi: hay hàm lượng giá cho mỗi nhiễm sắc thể hay chính là cho các phương án nghiệm trong tập nghiệm. Hàm này dùng để đánh giá độ thích nghi của các nhiễm sắc thể. Hàm thích nghi cần phải đánh giá được mức độ thích nghi cho tất cả các nghiệm khả thi và luôn được giả định là không âm, để thể hiện độ thích nghi của các cá thể. Công thức biểu diễn hàm cần phải thể hiện được tất cả các đặc tính mong muốn của nhiễm sắc thể, thông qua đó có thể chọn lọc được các quần thể nghiệm tốt nhất cho bài toán.

d) Quá trình lai ghép: đây là quá trình nhiễm sắc thể mới được hình thành dựa trên nhiễm sắc thể cha mẹ bằng cách lai ghép một hay nhiều đoạn nhiễm sắc thể cha mẹ với nhau. Phép lai ghép xảy ra với xác suất là p1 có thể được mô phỏng như sau:
- Chọn hai (hay nhiều) cá thể bất kỳ trong quần thể. Quần thể ở đây bao gồm các nhiễm sắc thể (cha mẹ) có độ dài bằng nhau.
- Chọn điểm lai là một điểm có vị trí bất kỳ (như nhau) trên nhiễm sắc thể chamẹ và thực hiện hoán đổi các đoạn gen của nhiễm sắc thể cha mẹ tại điểm lai này.
- Đưa hai cá thể này vào quần thể để thực hiện vào các quá trình tiến hóa tiếp theo.


Hình 1.  Lai ghép hai cá thể


Tuy nhiên trong quá trình tồn tại và phát triển, thuật toán di truyền đã được bổ sung rất nhiều các phương pháp lai ghép để nhằm thích ứng với nhiều kiểu bài toán và cũng là để tăng hiệu quả của thuật toán. Có thể kể một số phép lai cải tiến như sau:
- Lai ghép có xét tới các đặc tính trội và lặn trong tự nhiên: Các đặc tính này được quy định trước trong khi biểu diễn cấu trúc nhiễm sắc thể. Bằng việc xem xét tới các đặc tính trội lặn, quá trình sản sinh ra các "quần thể chất lượng tốt" sẽ nhanh hơn và do đó thời gian tính toán cũng được rút ngắn.
- Lai ghép từng phần: Việc giữ lại những đoạn mã đã "tối ưu" trong nhiễm sắc thể cũng là một cách để quá trình lai ghép trở nên hiệu quả hơn
- Lai ghép có trật tự
- Lai ghép dựa trên vị trí
- Lai ghép chu trình
- Lai ghép thứ tự tuyến tính
- Lai ghép đa điểm: Với phương pháp này, chúng ta có thể cho 2 cá thể lai ghép ở 2 hay nhiều điểm lai ghép. Phương thức này làm cho thuật toán trở nên linh hoạt hơn, nhờ đó các thế hệ cá thể con cũng sẽ có chất lượng tốt hơn.

e) Quá trình đột biến: là quá trình cá thể con mang một hay một số tính trạng không có trong mã di truyền của cha mẹ. Quá trình này xảy ra với xác suất p2 (nhỏ hơn nhiều so với p1) có thể được mô tả như sau:
- Chọn ngẫu nhiên một cá thể bất kỳ trong quần thể
- Chọn một gen bất kỳ của cá thể vừa chọn
- Thay đổi giá trị gen đó (đối với cách mã hóa gen theo số nhị phân thì quá trình thay đổi giá trị là đổi giá trị từ 0 thành 1 hoặc từ 1 thành 0) rồi trả về quần thể để thực hiện các quá trình tiếp theo

Hình 2. Đột biến một nhiễm sắc thể

Tương tự như quá trình lai ghép, trong quá trình phát triển của thuật toán di truyền cũng đã được bổ sung rất nhiều cách thức để thực hiện quá trình gây đột biến ngày càng hiệu quả hơn:
- Đột biến đảo ngược (Inversion Mutation)
- Đột biến chèn (Insertion Mutation)
- Đột biến thay thế (Raplacement Mutation)
- Đột biến tương hỗ (Reciprocal Exchange Mutation)
- Đột biến dịch chuyển (Shift Mutation)

f) Quá trình chọn lọc: Quá trình mà các cá thể mới sinh ra được giữ lại hay bị loại bỏ khỏi quần thể dựa vào độ thích nghi của chúng. Độ thích nghi ở đây thường là một hàm gán một giá trị thực cho các cá thể trong quần thể. Đối với quá trình này có rất nhiều cách để xác định trình tự tính toán và thực hiện tùy vào cách lựa chọn độ thích nghi của cá thể nói riêng và của cả quần thể nói chung.

4. Các tham số của thuật toán di truyền

Kích cỡ hệ nghiệm (pop-size): số lượng cá thể phù hợp trong mỗi thế hệ Xác suất lai tạo (pc): xác suất để mỗi cá thể trong quần thể được tham gia quá trình lai ghép.

Xác suất đột biến (pm): xác suất để mỗi bit trong nhiễm sắc thể bị đột biến Thông thường, kích cỡ của quần thể phụ thuộc vào độ phức tạp của bài toán.

Bài toán càng phức tạp, nhiều ràng buộc - đơn hoặc đa mục tiêu - thì số lượng cá thể trong mỗi thế hệ càng phải lớn. Hai thông số xác suất trong quá trình di truyền có khoảng giá trị rất khác nhau. Đối với xác suất lai tạo, giá trị thường rơi trong khoảng 0,5 - 0,95 nhưng giá trị thông thường của xác suất đột biến thấp hơn nhiều, chỉ ở khoảng 0,001 - 0,05. Điều này cũng phản ánh đúng xác suất xảy ra hai quá trình trong thực tế.

Ưu điểm của thuật toán di truyền là một phương pháp tìm kiếm từ một quần thể các điểm chứ không phải một điểm. Điều này làm cho việc giải các bài toán đa mục tiêu hay việc tìm một tập hợp các phương án lân cận nghiệm trở nên dễ dàng. Thêm vào đó, việc đánh giá thông tin bằng hàm mục tiêu chứ không dùng đạo hàm hay các tri thức bổ sung cũng là một ưu điểm của thuật toán.


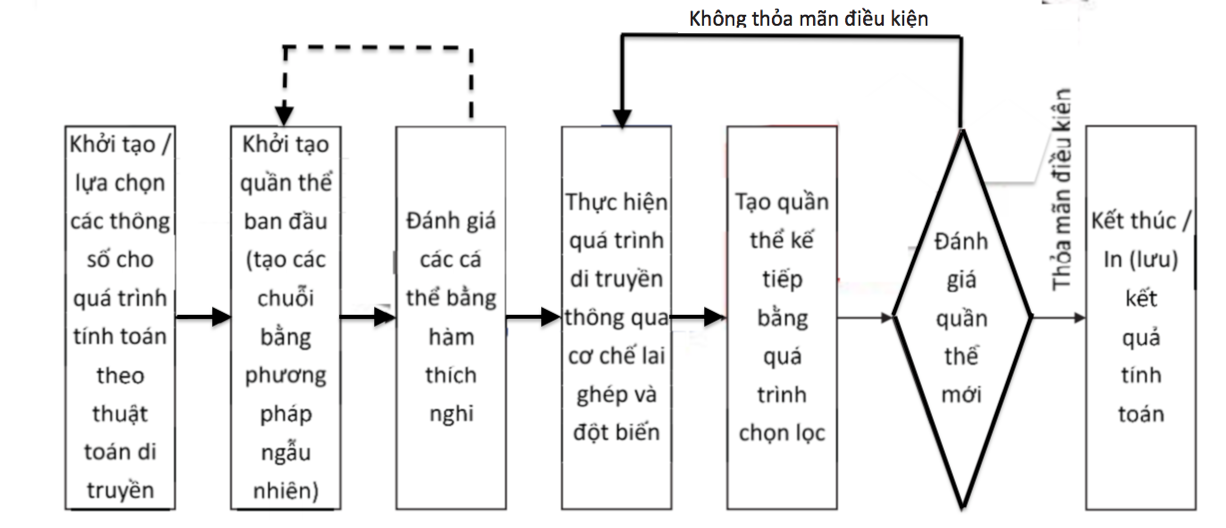
Hình 3. Sơ đồ quá trình tính toán của thuật toán di truyền 

Nhận xét cụ thể các bước trong lưu đồ trên:

- Bước 1: Khởi tạo/lựa chọn các thông số cho quá trình tính toán: Bước này người lập trình tính toán phải lựa chọn các thông số như: số lượng cá thể trong quần thể, cách thức hóa bài toán cần tính toán dưới dạng các nhiễm sắc thể (độ dài của nhiễm sắc thể, kiểu số biểu diễn dữ liệu,…), số thế hệ tính toán, xác suất lai ghép, xác suất đột biến, hàm thích nghi,…

- Bước 2: Khởi tạo quần thể ban đầu: xác định bằng phương pháp tạo số ngẫu nhiên để tạo giá trị cho các nhiễm sắc thể cho quần thể ban đầu. Tùy vào cách biểu diễn của các nhiễm sắc thể mà ta chọn phương pháp tạo số ngẫu nhiên phù hợp

- Bước 3: Đánh giá các nhiễm sắc thể bằng hàm thích nghi đã xác định ở bước
1. Trong bước này, ngoài việc đánh giá các nhiễm sắc thể riêng rẽ, chúng ta còn có thể đánh giá độ thích nghi của một nhiễm sắc thể hay cả quần thể. Nếu một nhóm hay cả quần thể có độ thích nghi "trung bình" (theo tiêu chí của từng trường hợp của người lập trình) thấp thì có thể loại nhóm nhiễm sắc thể hay quần thể đó ra khỏi quá trình di truyền.

- Bước 4: Thực hiện quá trình di truyền thông qua các cơ chế lai ghép và đột biến. Có thể thực hiện lần lượt hai quá trình này hoặc thực hiện đồng thời theo các phương pháp đã đề cập bên trên. Trong quá trình thực hiện thuật toán di truyền, giai đoạn này là giai đoạn mà mỗi người có thể thực hiện theo những phương pháp rất khác nhau. Giai đoạn này cũng là giai đoạn quyết định tới sự thành công của thuật toán. Người thực hiện cũng có thể đưa ra những phương thức tiến hành lai ghép hay đột biến mới trong giai đoạn này. Trong quá trình thực hiện, để có được một bộ các thông số lai ghép hay đột biến hiệu quả, người lập trình thường phải trải qua nhiều bước tính toán thử. Khâu này phụ thuộc nhiều vào kinh nghiệm và kỹ năng tính toán của người lập trình.

- Bước 5: Tạo quần thể mới bằng quá trình chọn lọc. Quá trình này cũng dựa vào đánh giá các nhiễm sắc thể thông qua hàm thích nghi. Cá thể nào có độ thích nghi cao sẽ được giữ lại cho thế hệ kế tiếp. Cũng giống như ở bước 3, chúng ta có thể sử dụng những hàm thích nghi phù hợp để đánh giá từng cá thể đơn lẻ hoặc cả một nhóm các cá thể. Sau quá trình này, nhóm cá thể nào thỏa mã tiêu chuẩn đánh giá với mức độ từ cao xuống thấp sẽ được dưa vào quần thể mới.

- Bước 6: Đánh giá quần thể vừa có được trong bước 5. Thông thường có hai tiêu chí để dừng quá trình di truyền tại bước này. Thứ nhất, độ thích nghi của từng cá thể và cả quần thể thỏa mãn một điều kiện hội tụ đã được đặt ra ban đầu. Các điều kiện hội tụ thể hiện mức độ chấp nhận được của kết quả tìm được. Thứ hai, quần thể mới tạo thành là quần thể ở thế hệ thứ (N+1) với N là số thế hệ dự định tính toán đã giả thiết ban đầu. Trong khi thực hiện các quá trình di truyền, những người tính toán có thể đưa ra những tiêu chí riêng để dừng quá trình di truyền. Các tiêu chí đưa ra góp phần quyết định tới thành công của thuật toán.

5. Cài đặt giải thuật di truyền [Tham khảo tại đây]

 >> Xem thêm phần cài đặt và ứng dụng thuật toán di truyển Tại đây

#

Categories

AI (23) AI programming (1) ASP (1) Android (32) Assembly (17) Biểu diễn thuật toán (1) Bubble-Sort (1) Bài giảng (2) Bài giảng lập trình C và Cpp (21) Bài viết hay (111) Bản đồ tư duy (1) C Plus Plus (102) C/C++ (16) CDSL phân tán (1) CSS (2) Cơ sở dữ liệu (11) Danh ngôn lập trình (1) Datamining (4) Genetic Algorithm (1) Giáo trình (3) Giải thuật tiến hóa - thuật toán di truyền (2) Google App Engine (2) Góc học tập (34) HTML (1) Hướng dẫn sử dụng Emu8086 (1) Học lập trình (133) Học lập trình C và CPP qua ví dụ (17) Java (54) Java Căn bản (6) JavaScript (5) Kỹ năng đọc hiệu quả (1) Kỹ thuật lập trình (16) Kỹ thuật đồ họa máy tính (10) Lý thuyết Cơ sở dữ liệu (2) Lý thuyết đồ thị (10) Lập trình Cơ sở dữ liệu (2) Lập trình Python (2) Lập trình căn bản (8) Lập trình hướng đối tượng với Java (7) Lập trình mobile (9) Lập trình mạng (6) Lập trình nhúng (1) Lập trình trí tuệ nhân tạo (2) ML (1) MS Access (1) Machine learning (6) Mạng máy tính (1) Mẹo tìm kiếm trên Google (1) Nghiên cứu khoa học (5) Ngôn ngữ lập trình (2) Những cuốn sách hay mà bạn nên đọc khi còn trẻ (1) Pascal (3) Phương pháp tính toán tối ưu (2) Phương pháp tối ưu (2) Quản lý dự án CNTT (1) SQL (5) Swift (9) Sách hay (4) Thiết kế Web (2) Thuật toán (50) Thuật toán Sắp Xếp -Sort (9) Thuật toán Tìm kiếm - Search (5) Thuật toán di truyền (4) Thực hành Android (2) Tin học văn phòng (5) Tiện ích máy tính (2) Toán rời rạc (12) Trí tuệ nhân tạo (24) Tài liệu tham khảo (3) Tìm hiểu Blockchain (2) Tự học Android (3) Tự học Android qua ví dụ (1) Tự học JavaScript (1) Tự học lập trình (9) Tự học lập trình Android (17) Tự học lập trình C và CPP (14) Tự học lập trình java qua các ví dụ (8) XML (1) blockchain (2) bài giảng quản lý dự án CNTT (1) bài tập java (3) bài tập lập trình (4) cấu trúc dữ liệu giải thuật (15) hướng dẫn viết báo (1) học lập trình Java (11) học máy (7) hợp ngữ (8) lập trình viên (5) phưng pháp đơn hình (2) thuật toán AI (2) tài liệu CNTT miễn phí (2) tính toán tối ưu (1) tự học lập trình iOS (8) tự học lập trình python (1) ví dụ Assembly (1) Đại số gia tử và ứng dụng (1) Đồ họa (4)